
Automazione documentale con AI e LLM: come trasformare documenti in workflow intelligenti
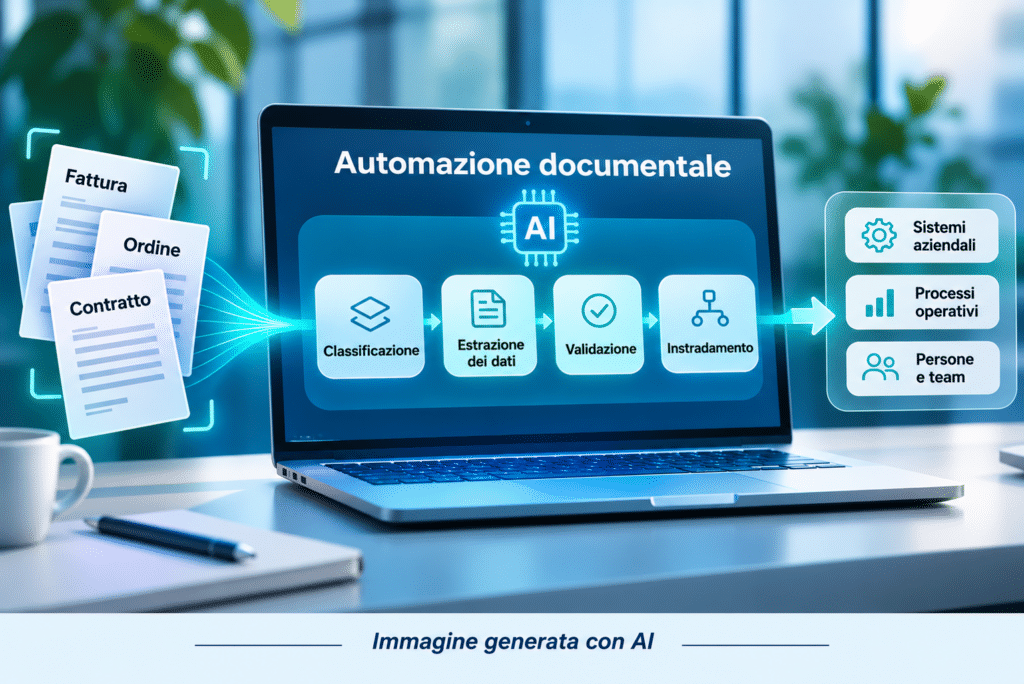
Ordini, fatture, richieste, moduli, contratti, comunicazioni… molti processi aziendali iniziano da un documento, che dà il via a una serie di attività. Qualcuno deve aprire il file, riconoscerne la tipologia, individuare le informazioni necessarie, verificarle, riportarle eventualmente in altri sistemi e capire a chi assegnare il passaggio successivo. Sono attività che, ripetute ogni giorno su grandi quantità di documenti, assorbono tempo e possono rallentare il lavoro delle persone coinvolte. L’automazione documentale può contribuire ad alleggerire questo carico operativo.
L’impiego di AI e Large Language Model (LLM) può supportare queste attività. Nell’ambito dell’Intelligent Document Processing (IDP), queste tecnologie possono essere utilizzate per classificare i documenti ed estrarre le informazioni necessarie. I dati recuperati possono quindi alimentare le attività successive, collegando l’elaborazione del documento al workflow aziendale.
Per capire cosa significa in concreto, immaginiamo il percorso di un documento dall’ingresso nel processo fino all’azione che deve generare
Automazione documentale: dal file all’avvio di un processo
Prendiamo come esempio una fattura. Il file arriva in azienda e deve essere riconosciuto. I dati presenti al suo interno devono poi essere recuperati e associati alle informazioni già disponibili nei sistemi aziendali. Possono servire controlli sulle informazioni estratte, così come la gestione di anomalie o eccezioni. Completate queste attività, la fattura deve raggiungere la destinazione prevista dal processo amministrativo.
AI e LLM possono supportare alcuni passaggi di questo percorso e collegare progressivamente il contenuto del documento alle attività successive:
Documento → Classificazione → Estrazione → Validazione → Instradamento → Azione
La sequenza non va intesa come uno schema rigido. Ogni processo ha caratteristiche proprie e può richiedere solo alcuni di questi passaggi, con livelli diversi di automazione e controllo umano. Il cambio di prospettiva riguarda soprattutto il modo in cui viene considerato il documento, non più come elemento isolato da gestire, ma in relazione al workflow di cui è parte.
Seguire il documento lungo il suo percorso aiuta a individuare le attività ripetitive e i passaggi nei quali le informazioni vengono ancora trasferite manualmente.
Classificare: riconoscere ciò che entra nel processo
Quando documenti di tipo diverso arrivano attraverso lo stesso canale, il processo deve innanzitutto riconoscerli.
La classificazione associa il documento alla categoria prevista dal workflow. Da questa informazione dipendono le operazioni successive: quali dati cercare, quali verifiche eseguire e quale percorso seguire.
Un esempio concreto arriva dal progetto sviluppato da Dilaxia per Transcoop, consorzio che coordina oltre 250 imprese associate e circa 900 mezzi di trasporto. La gestione centralizzata delle fatture relative alle consegne coinvolgeva un processo di raccolta dati gestito manualmente da più operatori. Tra le criticità rilevate c’erano errori nella registrazione e classificazione delle fatture, tempi lunghi per validazione e riconciliazione e difficoltà nell’attribuzione dei costi.
Per gestire questo flusso è nato Invoice Tagger, un’applicazione web che utilizza l’intelligenza artificiale per automatizzare la classificazione delle fatture di trasporto. I documenti vengono caricati in formato PDF o XML e da quel momento possono proseguire attraverso le attività previste dal processo.
L’input e l’output di questa prima fase sono concreti:
Input: una fattura PDF o XML che entra nel flusso.
Output: una fattura riconosciuta e pronta per le elaborazioni successive.
Una volta riconosciuta la tipologia documentale, il documento può proseguire verso la fase successiva del workflow, a partire dall’individuazione delle informazioni da estrarre.
Estrarre: portare i dati del documento dentro il processo
Dopo aver riconosciuto il documento, bisogna recuperare le informazioni necessarie per lavorarlo.
Nel caso Transcoop, Invoice Tagger estrae dalle fatture dati quali fornitore, mezzo, azienda associata, importi, codici e cliente finale. Queste informazioni vengono utilizzate nelle attività amministrative e nell’attribuzione dei costi ai soggetti coinvolti.
L’estrazione rende quindi disponibili per le fasi successive dati che prima erano contenuti nel PDF o nell’XML. Ciò che viene estratto dipende però dal processo. Una fattura richiede determinate informazioni; un ordine, un contratto o una cartella clinica ne richiedono altre.
Proprio la documentazione clinica mostra quanto questa attività possa diventare articolata. Nella gestione dei registri di patologia dell’Istituto Ortopedico Rizzoli, i professionisti analizzano cartelle, referti e lettere di dimissione redatti anche in linguaggio libero per individuare sintomi, diagnosi, procedure e trattamenti rilevanti.
Prima dell’introduzione di ICD Finder, l’attività prevedeva la lettura del testo e la successiva ricerca dei termini all’interno di portali specializzati per associarli ai codici standardizzati. Per alcuni termini complessi questa ricerca poteva richiedere fino a un’ora.
Dilaxia ha sviluppato per questo contesto un’applicazione che combina AI simbolica e AI generativa. I modelli LLM vengono utilizzati per interpretare il linguaggio naturale e gestire ambiguità e varianti lessicali, mentre la componente simbolica analizza il testo attraverso regole esplicite e dizionari clinici.
Fatture e documenti clinici hanno caratteristiche molto diverse. In entrambi i casi, però, il processo ha bisogno di recuperare informazioni contenute nei documenti e renderle utilizzabili nelle attività successive.
L’estrazione apre quindi un altro tema operativo: le informazioni recuperate possono richiedere una verifica prima che il workflow prosegua
Validare: stabilire quando serve una verifica
Regole aziendali, condizioni particolari ed eccezioni determinano il livello di controllo necessario sulle informazioni estratte e il ruolo delle persone nel processo.
Nel progetto Transcoop, per esempio, la soluzione evidenzia anomalie o incongruenze e permette agli operatori di correggere manualmente le eccezioni. I documenti che superano i controlli e risultano validi possono proseguire nel flusso, mentre le situazioni che richiedono attenzione vengono sottoposte a verifica da parte degli operatori.
ICD Finder mostra una modalità diversa di integrazione tra automazione e controllo umano. AI simbolica e AI generativa lavorano in parallelo e i risultati vengono consolidati considerando elementi come coerenza semantica, gerarchia e attendibilità. Il risultato proposto dallo strumento deve essere comunque sottoposto al controllo dell’operatore.
I due casi mostrano applicazioni differenti della Hybrid Intelligence, un approccio che combina il contributo dell’intelligenza artificiale con la supervisione e le competenze delle persone. Nel processo di Invoice Tagger l’intervento umano si concentra sulle anomalie e sulle eccezioni individuate durante l’elaborazione. Nel contesto di ICD Finder, l’operatore mantiene un ruolo di verifica all’interno di un’attività specialistica in cui la valutazione professionale resta parte integrante del processo.
Progettare la fase di validazione significa stabilire quando il documento può proseguire nel workflow, quando serve una conferma e quali casi richiedono la valutazione di una persona.
In questo modo, il livello di supervisione viene definito in funzione del processo, delle informazioni trattate e delle responsabilità coinvolte.
Completate le verifiche previste, documento e informazioni possono proseguire verso la destinazione successiva.
Instradare: far proseguire il documento nel workflow
Classificazione, estrazione e validazione preparano il passaggio successivo: l’instradamento.
In base alle informazioni disponibili e alle regole definite nel workflow, il documento può essere indirizzato a una persona, a una funzione aziendale, a un’applicazione oppure a un’altra fase del processo.
Il caso Transcoop consente di seguire anche questo passaggio. Dopo l’estrazione dei dati e la gestione delle eventuali anomalie, Invoice Tagger assegna ogni fattura al corretto centro di costo secondo le logiche aziendali. Il sistema genera quindi un flusso di dati pronto per l’inserimento nei sistemi contabili e di controllo di gestione.
Seguendo la stessa fattura dall’ingresso nel processo, il percorso diventa concreto: arrivo del documento → classificazione → estrazione dei dati → gestione delle eventuali anomalie → assegnazione del centro di costo → invio dei dati verso i sistemi amministrativi.
La continuità tra queste attività incide sul lavoro richiesto agli operatori: quando i dati estratti devono essere trasferiti in un altro applicativo oppure ogni documento deve essere smistato manualmente dopo l’elaborazione, alcune attività rimangono fuori dal flusso automatizzato.
Seguire l’intera sequenza permette di individuare i punti in cui il processo si interrompe, le informazioni cambiano sistema e le persone devono intervenire per collegare manualmente un’attività alla successiva.
Quanto lavoro c’è intorno a un documento?
Il carico operativo associato alla gestione documentale è spesso distribuito tra molte attività: apertura e lettura dei file, ricerca delle informazioni, inserimento dei dati, controlli, correzione delle eccezioni, smistamento e aggiornamento dei sistemi.
Considerate singolarmente, alcune richiedono poco tempo. La loro frequenza e il volume dei documenti possono però renderle rilevanti nel lavoro quotidiano.
Il caso di Transcoop offre una misura concreta di questa complessità. Prima dello sviluppo della soluzione, il processo di raccolta dei dati era gestito manualmente da più operatori, con tempi lunghi per le attività di validazione, riconciliazione e controllo e difficoltà nel tracciare mezzi, aziende e committenti e nell’attribuire correttamente i costi.
Anche all’Istituto Ortopedico Rizzoli il carico operativo emerge dalle attività svolte sui singoli documenti. I professionisti devono analizzare testi clinici non strutturati, individuare le informazioni rilevanti e ricercare i termini nei sistemi di codifica. Come visto, per alcuni termini complessi questa attività poteva richiedere fino a un’ora.
I due contesti mostrano come il lavoro legato alla gestione documentale possa distribuirsi tra molte attività, spesso poco visibili se si guarda solo al risultato finale. Ricostruire questa sequenza aiuta a capire dove si concentra il lavoro operativo e quali passaggi possono essere supportati dall’automazione.
Dal singolo task a un workflow documentale end-to-end
Automatizzare una singola attività può alleggerire una parte del lavoro. Per valutare l’effetto sul processo è utile osservare anche ciò che accade prima e dopo quel passaggio.
Un sistema può, per esempio, estrarre correttamente i dati da una fattura. Se successivamente un operatore deve copiarli in un altro applicativo, verificarli e inoltrare manualmente il documento, il processo continua a richiedere diversi interventi. Lo stesso accade quando la classificazione viene automatizzata e tutte le attività successive rimangono manuali.
La prospettiva end-to-end ricostruisce l’intero percorso: ingresso del documento, interpretazione delle informazioni, verifiche, gestione delle eccezioni, destinazione e aggiornamento dei sistemi coinvolti.
AI e LLM possono supportare specifiche attività lungo questa sequenza. Regole di processo, responsabilità, controlli e gestione delle eccezioni definiscono come le diverse attività devono collegarsi tra loro.
I casi di Invoice Tagger e ICD Finder permettono di osservare questa logica in due contesti diversi: un flusso amministrativo che coinvolge più fasi dell’elaborazione documentale e un’attività specialistica in cui l’AI supporta l’analisi mantenendo la verifica dell’operatore.
Osservare il workflow end-to-end aiuta quindi a individuare dove si concentrano le attività manuali e in quali passaggi l’automazione documentale può intervenire. Per farlo, è utile partire dal processo così come viene gestito oggi.
Da dove partire per valutare un processo documentale
Per capire dove può intervenire l’automazione documentale, conviene ricostruire il percorso attuale dei documenti aziendali e osservare le attività svolte dalle persone coinvolte.
Una prima analisi può concentrarsi su alcune domande:
- Quali documenti entrano nel processo e attraverso quali canali?
- Chi deve identificarli e leggerli?
- Quali informazioni vengono cercate?
- Dove vengono riportati i dati recuperati?
- Quali verifiche vengono effettuate?
- Quali anomalie o eccezioni richiedono l’intervento di una persona?
- Chi o quale sistema deve ricevere il documento dopo i controlli?
- Quali informazioni vengono trasferite manualmente tra applicazioni diverse?
- Quali attività vengono ripetute per ogni nuovo documento?
Anche i passaggi apparentemente semplici meritano attenzione. Copiare un dato da un documento a un gestionale, verificare un’informazione o inoltrare un file al reparto corretto può richiedere pochi minuti, ma la frequenza con cui queste operazioni vengono ripetute determina il loro peso sul processo.
La mappatura permette quindi di distinguere le attività ripetitive da quelle che richiedono competenza, valutazione o responsabilità decisionale.
Questa analisi offre una base concreta per valutare l’automazione a partire dal lavoro reale svolto ogni giorno. Classificazione, estrazione, validazione e instradamento possono essere collegate all’interno dello stesso workflow, definendo per ogni passaggio il contributo dell’AI, le regole di processo e il livello di intervento umano necessario.
Domande frequenti sull’automazione documentale con AI
Quali documenti aziendali possono essere gestiti con l’automazione documentale?
L’automazione documentale può essere applicata a fatture, ordini, contratti, moduli e documentazione specialistica. Le attività da automatizzare dipendono dal tipo di documento e dal processo aziendale: possono comprendere la classificazione, l’estrazione dei dati, la verifica delle informazioni e, nei casi più complessi, l’interpretazione del linguaggio naturale.
Qual è il ruolo degli LLM nell’automazione documentale?
I Large Language Model (LLM) possono aiutare a interpretare le informazioni contenute nei documenti, soprattutto quando sono espresse in linguaggio naturale o presentano formulazioni ambigue. Possono essere utilizzati insieme ad altre tecnologie, come l’AI simbolica, che impiega regole esplicite e dizionari per analizzare il testo. La combinazione dipende dalle caratteristiche dei documenti e dalle esigenze del processo.
Quando è necessario il controllo umano in un workflow documentale automatizzato?
Il controllo umano interviene quando occorre verificare informazioni, gestire anomalie o effettuare valutazioni specialistiche. Il livello di supervisione dipende dalle caratteristiche del processo e dalle responsabilità coinvolte.
Come capire se un processo documentale è adatto all’automazione?
Per valutarlo occorre ricostruire il percorso dei documenti, individuando le informazioni da estrarre, i controlli necessari e i passaggi ancora manuali. Questa analisi aiuta a riconoscere le attività ripetitive che possono essere automatizzate e quelle che richiedono l’intervento delle persone, considerando anche il collegamento con i sistemi aziendali.
Rendi i flussi operativi più semplici, fluidi, tracciabili e semplifica il lavoro quotidiano.